1. Vocabulaire de la statistique
En magasin, on collecte sans cesse des données : nombre de clients, montant des tickets, temps d'attente en caisse, notes de satisfaction… La statistique permet d'organiser ces données, de les représenter et de les résumer pour prendre des décisions (horaires des caissiers, réassort, promotion…).
Définitions.
• La population est l'ensemble sur lequel porte l'étude (ex. : les clients d'un magasin un samedi).
• Un individu est un élément de la population (ex. : un client).
• Le caractère est ce qu'on observe sur chaque individu (ex. : le montant de son ticket).
• L'effectif d'une valeur est le nombre de fois où elle apparaît. L'effectif total est noté N.
• La fréquence d'une valeur est : fréquence = effectif ÷ N. Elle est souvent exprimée en %.
Types de caractères.
• Qualitatif : le caractère n'est pas un nombre (ex. : mode de paiement : carte, espèces, chèque).
• Quantitatif discret : le caractère prend des valeurs isolées (ex. : nombre d'articles achetés : 1, 2, 3…).
• Quantitatif continu : le caractère peut prendre n'importe quelle valeur dans un intervalle (ex. : temps d'attente en caisse en minutes). On le regroupe alors en classes comme [0 ; 5[, [5 ; 10[…
2. Regrouper les données en tableau
Exemple. Une caissière relève le temps d'attente (en minutes) de 20 clients : on le regroupe en classes de 5 minutes.
La somme des fréquences est toujours égale à 1 (ou 100 %) : c'est un bon réflexe de vérification.
| Temps d'attente (min) | Effectif | Fréquence |
|---|---|---|
| [0 ; 5[ | 7 | 7 ÷ 20 = 0,35 soit 35 % |
| [5 ; 10[ | 9 | 9 ÷ 20 = 0,45 soit 45 % |
| [10 ; 15[ | 4 | 4 ÷ 20 = 0,20 soit 20 % |
| Total | 20 | 100 % |
3. Représentations graphiques
- Diagramme en secteurs (camembert) : idéal pour un caractère qualitatif. L'angle de chaque secteur est proportionnel à l'effectif : angle = fréquence × 360°.
- Diagramme en bâtons : pour un caractère quantitatif discret (une valeur = un bâton, hauteur = effectif).
- Diagramme en colonnes (histogramme) : pour des données regroupées en classes ; les colonnes sont collées car les classes se suivent.
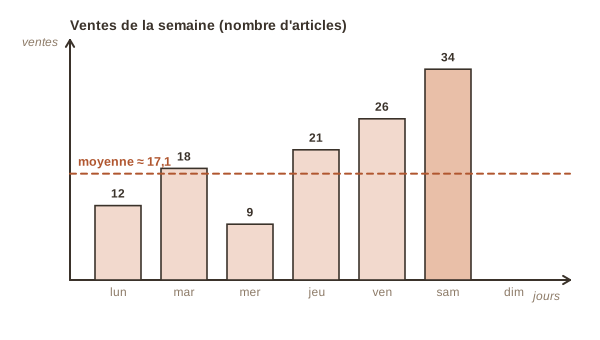
- Ligne brisée (polygone) : pour suivre une évolution dans le temps (ventes jour par jour, fréquentation par mois).
Exemple. Modes de paiement sur 100 clients : carte 55, espèces 35, chèque 10.
Pour un diagramme en secteurs : carte → 0,55 × 360° = 198° ; espèces → 0,35 × 360° = 126° ; chèque → 0,10 × 360° = 36°. Vérification : 198 + 126 + 36 = 360°.
Pour un diagramme en secteurs : carte → 0,55 × 360° = 198° ; espèces → 0,35 × 360° = 126° ; chèque → 0,10 × 360° = 36°. Vérification : 198 + 126 + 36 = 360°.
4. Les indicateurs de position
Mode et classe modale.
• Le mode est la valeur qui a le plus grand effectif (série non groupée).
• La classe modale est la classe qui a le plus grand effectif (données groupées en classes).
• Le mode est la valeur qui a le plus grand effectif (série non groupée).
• La classe modale est la classe qui a le plus grand effectif (données groupées en classes).
Moyenne.
• Série simple : moyenne = (somme de toutes les valeurs) ÷ N.
• Série avec effectifs (moyenne pondérée) :
moyenne = (n1x1 + n2x2 + … + npxp) ÷ N
• Données en classes : on remplace chaque classe par son centre = (borne inf + borne sup) ÷ 2. On obtient alors une valeur approchée de la moyenne.
• Série simple : moyenne = (somme de toutes les valeurs) ÷ N.
• Série avec effectifs (moyenne pondérée) :
moyenne = (n1x1 + n2x2 + … + npxp) ÷ N
• Données en classes : on remplace chaque classe par son centre = (borne inf + borne sup) ÷ 2. On obtient alors une valeur approchée de la moyenne.
Exemple. Nombre d'articles par ticket sur 30 tickets :
Moyenne = (1×8 + 2×12 + 3×7 + 4×3) ÷ 30 = (8 + 24 + 21 + 12) ÷ 30 = 65 ÷ 30 ≈ 2,2 articles par ticket.
| Nombre d'articles x | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| Effectif n | 8 | 12 | 7 | 3 |
Médiane. La médiane (notée Me) est la valeur qui partage la série ordonnée en deux groupes de même effectif : au moins 50 % des valeurs sont inférieures ou égales à Me, et au moins 50 % sont supérieures ou égales à Me.
• Si N est impair : Me = valeur centrale.
• Si N est pair : Me = moyenne des deux valeurs centrales.
• Si N est impair : Me = valeur centrale.
• Si N est pair : Me = moyenne des deux valeurs centrales.
Quartiles.
• Le premier quartile Q1 est la plus petite valeur de la série telle qu'au moins 25 % des valeurs lui sont inférieures ou égales.
• Le troisième quartile Q3 est la plus petite valeur telle qu'au moins 75 % des valeurs lui sont inférieures ou égales.
Méthode pratique : on calcule N ÷ 4 pour Q1 et 3N ÷ 4 pour Q3, puis on prend la valeur du rang correspondant (en arrondissant le rang à l'entier supérieur).
Exemple complet. Temps d'attente (en min) de 10 clients, série déjà ordonnée :
2 ; 3 ; 3 ; 5 ; 7 ; 8 ; 8 ; 8 ; 10 ; 12. (N = 10)
• Médiane : N pair, deux valeurs centrales = 5e et 6e valeurs : Me = (7 + 8) ÷ 2 = 7,5 min.
• Q1 : N ÷ 4 = 2,5 → on prend la 3e valeur : Q1 = 3 min.
• Q3 : 3N ÷ 4 = 7,5 → on prend la 8e valeur : Q3 = 8 min.
Interprétation métier : la moitié des clients attend moins de 7,5 min ; un quart des clients attend plus de 8 min.
5. Les indicateurs de dispersion
Formules.
• Étendue = valeur maximale − valeur minimale.
• Écart interquartile = Q3 − Q1. Il contient les 50 % centraux des valeurs : il n'est pas sensible aux valeurs extrêmes.
• Écart type (noté σ, « sigma ») : il mesure la dispersion autour de la moyenne x̄ :
σ = √[ ( n1(x1 − x̄)2 + n2(x2 − x̄)2 + … ) ÷ N ]
En pratique, on le calcule à la calculatrice ou au tableur.
Exemple (suite). Pour la série des 10 temps d'attente : moyenne x̄ = 66 ÷ 10 = 6,6 min.
• Étendue = 12 − 2 = 10 min.
• Écart interquartile = Q3 − Q1 = 8 − 3 = 5 min.
• La calculatrice donne σ ≈ 3,1 min.
Comparaison : une autre caisse avec la même moyenne (6,6 min) mais σ = 1 min est beaucoup plus régulière : les clients y attendent tous à peu près le même temps.
• Étendue = 12 − 2 = 10 min.
• Écart interquartile = Q3 − Q1 = 8 − 3 = 5 min.
• La calculatrice donne σ ≈ 3,1 min.
Comparaison : une autre caisse avec la même moyenne (6,6 min) mais σ = 1 min est beaucoup plus régulière : les clients y attendent tous à peu près le même temps.
6. Le diagramme en boîte à moustaches
Définition. La boîte à moustaches résume une série avec 5 nombres : minimum, Q1, médiane, Q3, maximum. La « boîte » va de Q1 à Q3 (elle contient 50 % des valeurs) ; les « moustaches » vont du minimum à Q1 et de Q3 au maximum.
Comparer deux séries avec des boîtes à moustaches.
1. Placer les deux diagrammes sur le même axe gradué.
2. Comparer les médianes : laquelle est la plus grande ?
3. Comparer les longueurs des boîtes (écart interquartile) : la plus courte indique la série la plus homogène.
4. Rédiger une phrase de conclusion adaptée à la situation (ex. : « le magasin B a des ventes médianes plus élevées mais plus irrégulières »).
Erreurs fréquentes à éviter.
• Oublier d'ordonner la série avant de chercher médiane et quartiles.
• Confondre moyenne et médiane : la moyenne est sensible aux valeurs extrêmes (un ticket à 900 € fait grimper la moyenne du panier), pas la médiane.
• Additionner les fréquences et trouver un total ≠ 100 % sans réagir : il y a une erreur.
• Calculer une moyenne de données en classes sans utiliser les centres de classes.
• Conclure qu'un écart type plus grand signifie « plus de ventes » : il signifie « ventes plus dispersées ».